Краткое саммари
Чтобы найти страницы-сироты, нужно сравнить независимый список URL из CMS, XML sitemap и других доступных источников с результатом завершенного обхода от главной по внутренним ссылкам.
Адреса, которых в обходе нет, проверьте по доступности, назначению и входящим связям. И затем нужному материалу верните ссылку с подходящей страницы, до которой тоже можно дойти от главной.
При повторном обходе краулер должен добраться до нужного URL по внутренним ссылкам сайта. Адрес из sitemap или файла в этот запуск не добавляйте.
Кому будет полезно прочитать статью:
Статья пригодится SEO-специалистам после миграции или изменения каталога, а также редакторам, которые возвращают старые материалы в доступные разделы.
Содержание
Допустим, вы обновили рубрики в блоге интернет-магазина сантехники. Открываете раздел обслуживания, а инструкции по замене фильтра для воды там больше нет. Да, по прямой ссылке статья открывается — текст там никуда не делся. Но покупатель этой ссылки не знает и через этот раздел к инструкции уже попасть не сможет. Получается, вы сделали страницу сиротой.
В медицине это особенно критично: статьи о симптомах, подготовке к анализам и реабилитации часто живут годами и приносят трафик из поиска, но после редизайна или смены CMS могут выпасть из навигации. Если такая страница еще и содержит медицинские рекомендации, потеря внутренних ссылок бьет не только по SEO, но и по доверию, потому что пациент не находит проверенный материал и уходит на сторонний ресурс.
Ксения Зайцева, SEO-специалист по медицинским сайтам
Как найти страницы-сироты
Страница-сирота, или orphan page, — URL без входящих внутренних ссылок с других страниц того же сайта. Чтобы найти такие потерянные материалы, мы проверим сайт в три шага. Сначала соберем опубликованные адреса и сравним их с обходом от главной. Затем разберем URL, которых краулер не нашел, и выясним, где пропали ссылки, а где обходу помешали ошибки или настройки.
1. Собираем адреса опубликованных материалов и сохраняем в инвентарь
Из CMS выгрузите адреса опубликованных статей, товаров, категорий и других публичных HTML-страниц. Черновики и личный кабинет отделите от материалов для посетителей.
Из XML sitemap получите URL основной и вложенных карт. Если карта еще не настроена, сформируйте ее в CMS по руководству о sitemap и сверьте с опубликованными страницами.
Из Метрики или другой аналитики выгрузите URL, на которых начинались визиты за выбранный период. Для сезонного архива включите в него весь сезон.
В Яндекс Вебмастере соберите доступные адреса из отчетов о страницах и поисковых результатах. Если отслеживаете также Google, дополните список данными Search Console.
Из серверных логов получите URL, которые запрашивали посетители и роботы. Служебные ресурсы, ошибки и старые редиректы сгруппируйте по типам, чтобы с ними было удобнее работать дальше.
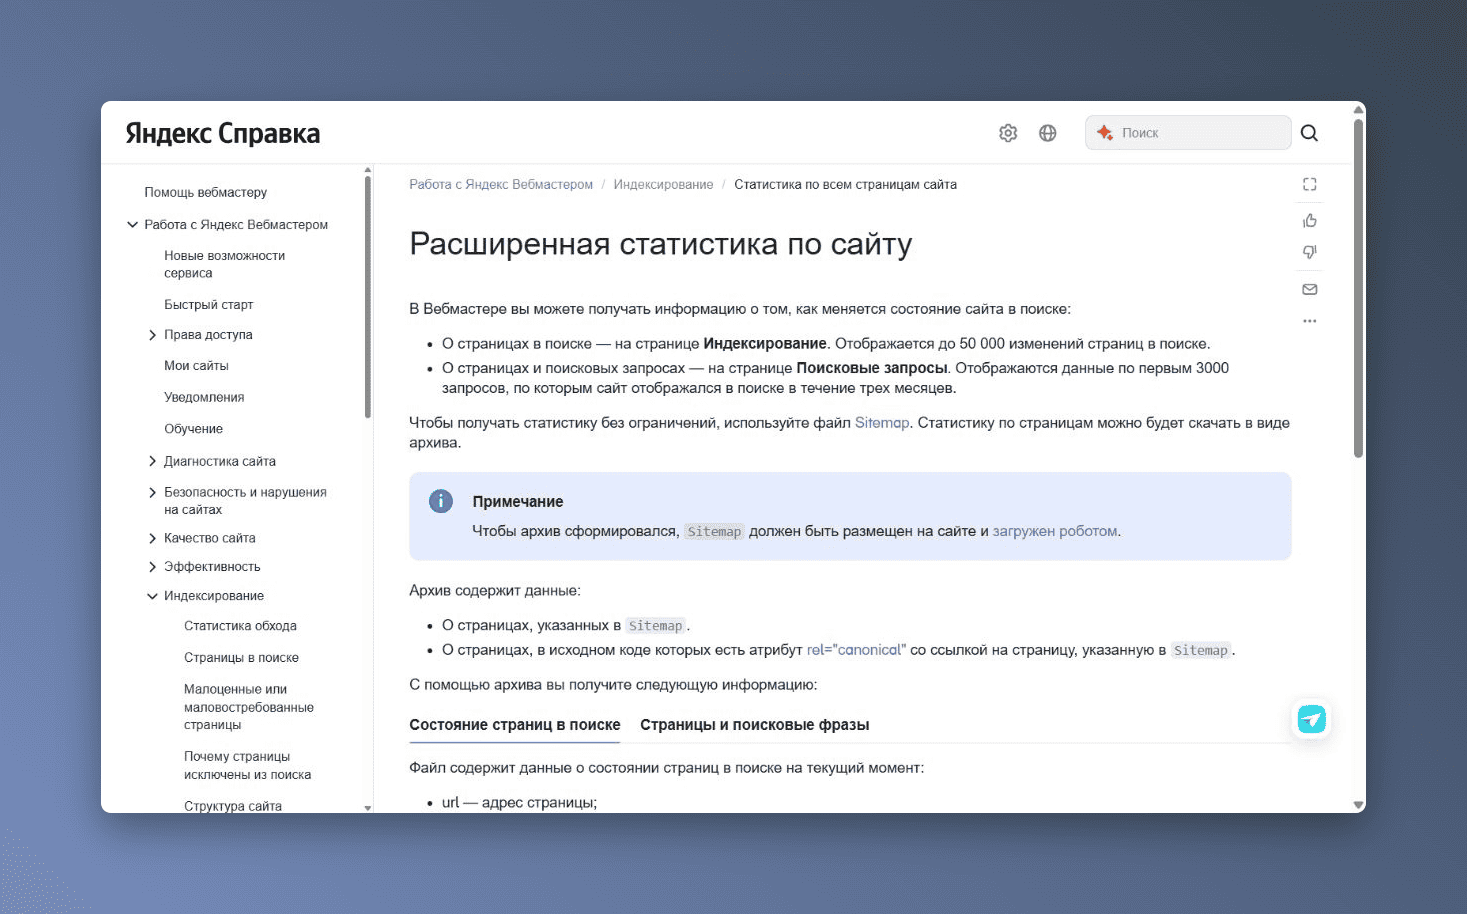
Еще в Яндекс Вебмастере можно скачать архив со страницы «Все страницы». Он содержит адреса из обработанного sitemap и страницы, canonical которых указывает на URL из этой карты. Для каждого адреса в архиве есть статус страницы в поиске, код ответа при последнем обходе и дата посещения роботом.
Также сохраните источник и период данных. Адрес нашей инструкции из примера https://example.com/blog/filter-replacement/ есть в CMS и sitemap, поэтому он попадет в список, даже если за месяц на страницу никто не пришел.
Важно не только найти, но и отличить сироту от ошибки обхода. Не спешите лепить внутренние ссылки на каждый URL, который не попал в отчет краулера. Отсутствие страницы в результатах краулинга - еще не ярлык «сирота». Может, она просто стесняется)). А может, краулер до нее банально не добрался.
Прежде чем устраивать странице «усыновление» через перелинковку, прогоните ее через чек-лист:
1. Жива ли страница вообще? Код ответа 200? Есть ли noindex, стр не запрещен в robots.txt?
2. Тот ли это адрес (т.е финальный url после всех редиректов), указан ли canonical?
3. Добрался ли краулер до ссылки, не уперся ли в лимит, просмотрены ли все поддомены? Если контент загружается с помощью JavaScript, тогда обход должен быть строго с рендерингом, потому что без JS краулер вместо страницы видит красивую пустоту.
Евгения Варавина, SEO-специалист digital-агентства 1PS.RU
2. Сравниваем инвентарь с обходом от главной
Запустите краулер от главной так, чтобы новые страницы он находил только по внутренним ссылкам. Инвентарь и sitemap в этот обход не загружайте.
Дождитесь завершения и проверьте, охватил ли краулер нужные разделы и поддомены, не остановился ли на лимите страниц или ошибках загрузки. Изучите запреты robots.txt. Если ссылки создает JavaScript, включите рендеринг, чтобы программа выполнила скрипты и прочитала получившийся HTML.
Именно сопоставление карты с завершенным обходом использовали в исследовании PageSpeed Matters за октябрь 2026 года. На 77 сайтах с не более чем 900 URL в sitemap каждый обход закончился до лимита 1000 страниц. Из 16 587 адресов карты 1407, или 8,5%, не получили входящих ссылок из обойденной части сайтов. Если ваш краулер остановится раньше, в список кандидатов попадут и страницы, до которых он еще не дошел.
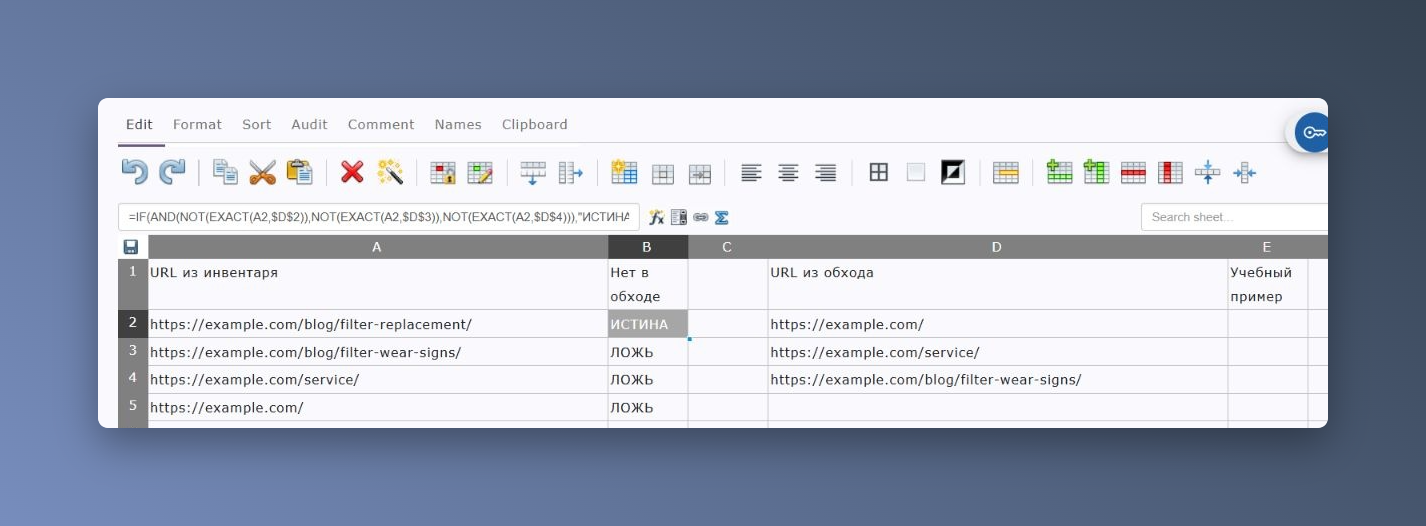
Для сверки можно создать два листа, например, в Excel или в Google Таблицах. «Инвентарь» заполните объединенными URL, а «Обход» — адресами, найденными по ссылкам от главной. На обоих листах разместите абсолютные URL в столбце A начиная с ячейки A2. Уберите пробелы по краям и точные повторы, сохранив сведения об источниках в столбце C и следующих столбцах.
На листе «Инвентарь» в ячейке B1 напишите «Нет в обходе». В B2 — ячейку столбца B во второй строке — вставьте формулу:
=СУММПРОИЗВ(--СОВПАД(A2;Обход!$A$2:$A$10000))=0
ИСТИНА означает, что точного URL из A2 нет в указанном диапазоне листа «Обход». Подстройте последнюю строку диапазона под размер выгрузки, сохранив знаки $. Протяните формулу вниз до последней строки с URL и отфильтруйте ИСТИНА в столбце B. СОВПАД учитывает регистр и сравнивает знаки вроде ? буквально, поэтому адреса с параметрами участвуют в точном сравнении.
Сохраняйте регистр пути и параметры, к примеру, для /Guide/ и /guide/ проверьте содержимое и ответы сервера. Различия HTTP/HTTPS, www и завершающего слеша тоже разберите по фактическим переходам.
У нашей инструкции о фильтре результат — ИСТИНА: CMS хранит ее адрес, но краулер из навигации его не нашел. Отфильтрованную строку перенесите в список кандидатов.
3. Разбираем адреса, которые краулер не нашел
Импортируйте отфильтрованный список в краулер и проверьте сами адреса. Теперь программа загрузит кандидатов напрямую, чтобы вы могли выяснить их состояние и связи между ними.
Сначала проследите редиректы и откройте конечный URL. По нему должен загружаться сам материал с кодом 200. В инвентаре сохраняйте исходный адрес вместе с конечным. Если старый URL перенаправляет на страницу, доступную из структуры, пометьте его как устаревший.
Затем прочитайте содержимое, проверьте canonical и запреты обхода навроде noindex. Для адресов, по которым материал больше не загружается, проверьте неработающие ссылки (в Яндексе это будут адреса с кодами 4xx и 5xx). Запишите код ответа и страницу, с которой ведет этот переход, в инвентарь.
Если найденная страница указывает canonical на другой URL, сначала нужно решить, какая версия должна участвовать в поиске. Восстанавливать ссылки на дубль без такого решения не нужно. Для выбранной основной версии важно согласовать внутренние ссылки, sitemap и canonical, чтобы сайт не давал поисковику противоречивые сигналы.
Ольга Костенко, SEO-маркетолог, руководитель агентства okostenko.agency
Если адрес загружается, разберите его входящие связи. Здесь вам могут встретиться три ситуации:
На страницу нет ссылок с других страниц сайта. Тогда запишите адрес в группу материалов без входящих связей.
Ссылка есть из глубокой архивной рубрики. Сначала завершите обход этой рубрики, возможно, обход остановился по лимиту.
Наша инструкция о фильтре и, например, статья об очистке корпуса ссылаются друг на друга, но обе отсутствуют в обходе от главной. Это изолированный кластер — группа связанных страниц, до которых нельзя дойти из главной по внутренним ссылкам. Фильтр «0 входящих» пропустит такую пару. Отметьте обе страницы как группу, недоступную из структуры.
Если ссылка есть на экране, но краулер ее не прочитал, сопоставьте исходный и отрендеренный HTML. Каждый документ должен быть доступен по HTML-ссылке <a href>. Для JavaScript проверьте, появился ли этот элемент после выполнения скриптов, затем повторите обход с нужными настройками.
Самые частые случаи - когда такие страницы не имеют входящих ссылок с других страниц сайта. Лучший способ это выгрузка из CMS сайта и сопоставление списка реальных URL-адресов с результатом парсинга (например, screaming frog).
В чем основная проблема таких страниц - так как они не имеют связи с сайтом, краулерам поисковых систем о них узнать будет практически невозможно, и ссылочный вес не будет до них доходить, а значит поведенческие не будут аккумулироваться.
Если эти страницы актуальны и рабочие, нужно добавить на них ссылки с других страниц сайта и добавить в файл sitemap.xml, если нет - подклеить 301-редиректом к актуальной.
Иван Сиваков, Senior SEO компании WSS. Специалист в области E-commerce, Fintech, Medicine, AIO
Что делать с найденными страницами
Сначала разберемся, что делать с найденными материалами. Для каждого выберем действие — вернуть в структуру сайта, обновить, объединить с другим или удалить. Для страниц, которые возвращаем, выберем доноров и добавим ссылки в CMS. После правки повторим обход и проверим, появился ли путь от главной.
1. Выбираем, какие материалы возвращать
Допустим, фильтр из нашей инструкции еще продается, а покупателю нужно понять, как его поменять. Такой материал возвращаем в раздел обслуживания. Если инструкция устарела, сначала исправьте ее текст.
Если же материал остался актуальным, но найденная ссылка ведет на удаленный адрес, исправьте битую ссылку на странице-источнике — укажите URL актуальной версии.
Для других адресов решение зависит от содержимого. К примеру, если тему страницы уже полностью раскрывает другой материал, перенесите в него нужные сведения, настройте постоянный редирект и обновите внутренние ссылки до конечного URL.
Прежде чем объединять страницы или удалять их, выясните, сколько посещений и конверсий они приносят. Затем проверьте, какие внешние ссылки ведут на эти страницы. Так в ваш вывод попадет и то, откуда к материалу приходят посетители. Первыми займитесь адресами, которые решают важную задачу, приносят обращения или имеют ценные внешние ссылки.
Возвращать в структуру каждую найденную сироту не нужно. Обычно заметная часть списка — это старые акции, тестовые страницы и дубли, которые и без ссылок никому не нужны. Порядок мы определяем по пользе: сначала страницы, которые приводят посетителей или заявки, потом те, на которые ссылаются другие сайты, а остальное разбираем в последнюю очередь.
Эдуард Трубченинов, основатель агентства поискового продвижения PrivateSEO
Окончательно ненужный материал без подходящей замены удалите. Для удаленного адреса возвращайте HTTP-код 404 или 410. Устаревший URL уберите из sitemap и внутренних ссылок.
В медицинской тематике перед удалением страницы обязательно проверьте, есть ли на нее внешние ссылки — с профильных ресурсов, справочников или сайтов новостей. Если такие ссылки есть, лучше поставить 301 (308) редирект на подходящую по смыслу страницу.
Ксения Зайцева, SEO-специалист по медицинским сайтам
У посадочной конкретной кампании сначала определите аудиторию и ее путь на страницу, и затем решите, нужна ли она в поиске. Если индексация не нужна, разместите noindex в метатеге robots или HTTP-заголовке. Обход этой страницы в robots.txt разрешите.
Напротив инструкции о фильтре в инвентаре запишите «Вернуть в раздел обслуживания» и причину — оборудование еще продается. Для остальных адресов укажите другие действия. По этому списку можно распределить правки между редактором и разработчиком.
2. Находим страницу, с которой нужен переход
Выберите донора для внутренней ссылки — страницу-источник, с которой читателю нужен переход к найденному материалу. До самого донора тоже должен быть путь по ссылкам от главной.
Например, в магазине есть статья о признаках износа фильтра. После объяснения, как понять, что фильтр выработал ресурс, читателю потребуется гайд, как его заменить. Здесь и будет ссылка на инструкцию. Добавьте в план правок и карточку материала в разделе обслуживания. Через нее посетитель сможет найти инструкцию при выборе темы.
Для двух взаимно связанных инструкций из примера выберите доступный раздел, с которого поставите ссылку хотя бы на одну из них. При повторном обходе проверьте достижимость обеих.
Кейс по теме: в октябре 2026 года команда Apzom работала с архивом почти из 8000 статей, составляла карту внутренних связей и добавляла ссылки между статьями и тематическими центрами. Число сирот снизилось с 4217 до 3635, а контекстных ссылок выросло — с 11 420 до 12 978.
В своем архиве подбирайте доноров для сохраненных материалов и записывайте место перехода в инвентаре. После правки дополните запись результатом обхода, чтобы продолжить работу с оставшимися адресами.
При выборе места перехода учитывайте, что посетитель делает на странице-источнике. В A/B-тесте SearchPilot от 30 сентября 2026 года название бренда на карточке товара стало ссылкой на список товаров этого бренда. Эти страницы списков уже получали ссылки из навигации и хлебных крошек. Авторы оценили рост их органического трафика в 18% и сообщают положительный результат при 95%-м байесовском интервале достоверности.
Другой вариант — общий блок переходов — проверили в двух тестах SearchPilot на туристическом сайте, опубликованных в марте 2026 года. Блок из 30 популярных направлений не дал заметного изменения трафика целевых страниц.
3. Сверяем ссылки донора и добавляем недостающую
Перед правкой выясните, нет ли в статье о признаках износа уже перехода к инструкции или ссылки на ее старый адрес. Сверить URL и анкоры можно в инструменте «Анализ внешних и внутренних ссылок».
Вставьте полный URL выбранной статьи в поле и нажмите «Проверить». В нашем примере это https://example.com/blog/filter-wear-signs/
В блоке «Внутренние ссылки» вы получите адреса переходов, их тексты и отметку nofollow, если атрибут присутствует. В отчет попадут и ссылки из меню, оглавления и футера. Сравните список с конечным URL инструкции https://example.com/blog/filter-replacement/. Если адрес найден, откройте ссылку на самом доноре и проверьте, где она размещена и что написано в анкоре.
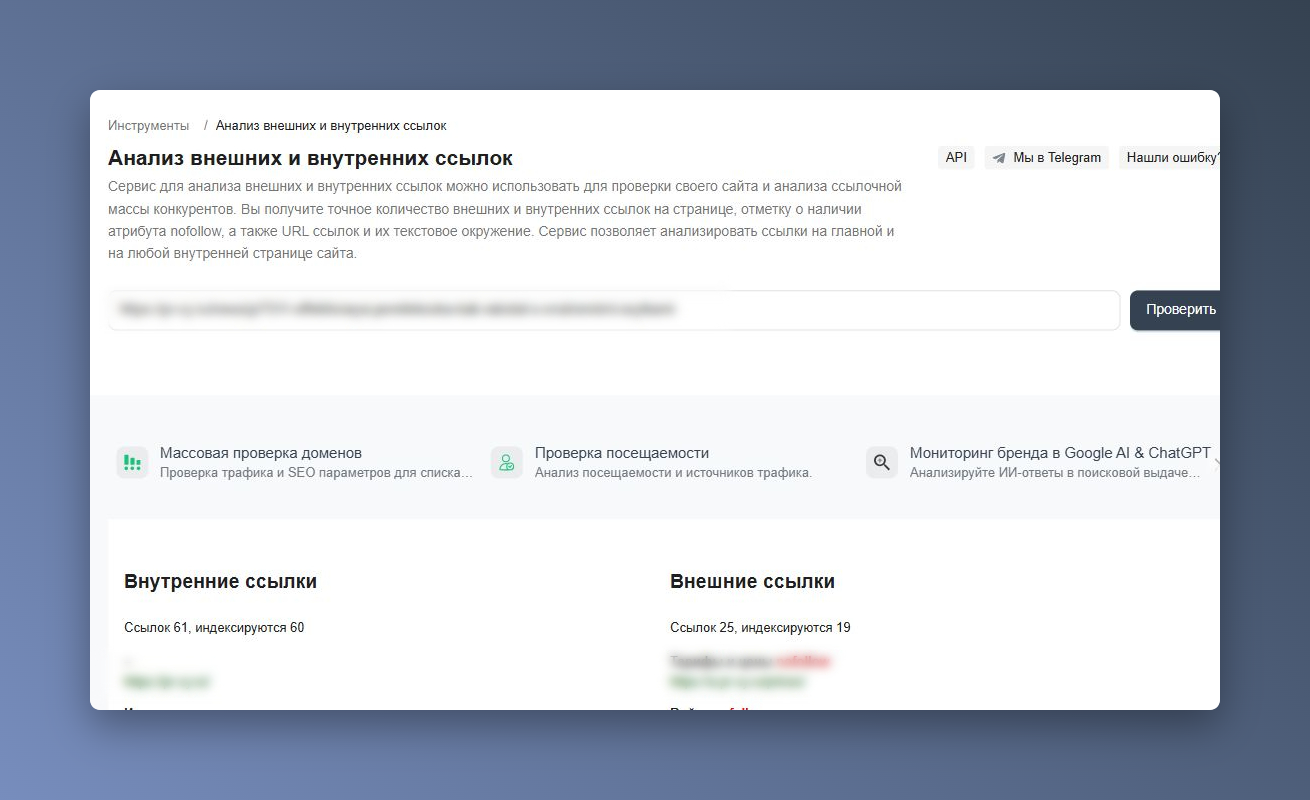
После сверки переходите к CMS. При отсутствии ссылки добавьте ее в предложение о фильтре, который выработал ресурс. Если ссылка ведет на старую версию, исправьте адрес на конечный URL актуального материала. А в разделе обслуживания восстановите карточку инструкции.
Используйте правильные анкоры, передающие действие, которое читатель выполнит после перехода. По исследованию LinkStorm, опубликованному в ноябре 2025 года и обновленному в январе 2026-го, около 15% из 2,5 млн контекстных ссылок на 1700 клиентских сайтах имели общие анкоры вроде «читать далее» или «нажмите здесь». В статье об износе можно поставить анкор «сменить фильтр по инструкции». Для карточки в разделе подойдет «Инструкция по замене фильтра».
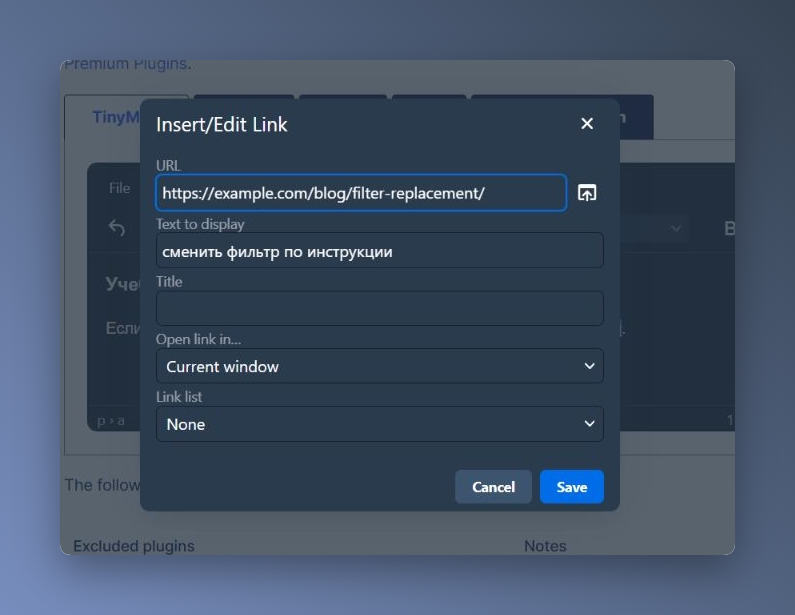
Если фильтр выработал ресурс, пора <a href="/blog/filter-replacement/">сменить фильтр по инструкции</a>.
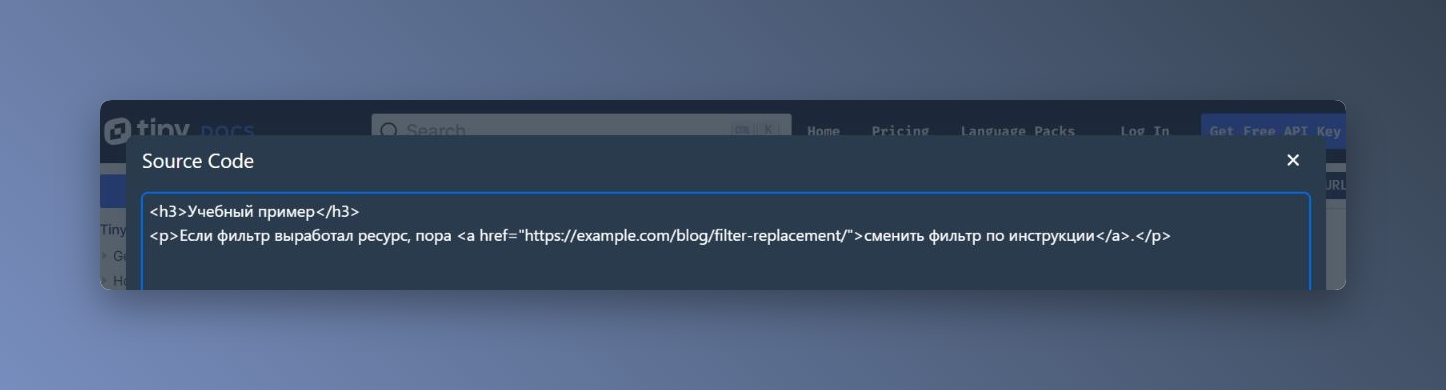
Свяжите материалы ссылкой без nofollow, прямо на нужный адрес. Читатель получит инструкцию, а робот сможет прочитать <a href>.
Сохраните правку в CMS и повторите проверку донора в инструменте для анализа ссылок. В отчете найдите текст «сменить фильтр по инструкции» и URL https://example.com/blog/filter-replacement/ без отметки nofollow, затем сверьте запись с опубликованной страницей.
4. Проверяем, что краулер дошел до инструкции
Повторите обход с прежним охватом и режимом обработки ссылок. Целевой URL из sitemap или файла не подмешивайте — краулеру нужно обнаружить его по внутренним ссылкам и указать донора.
У нашей инструкции на сайте появились два пути. Из раздела обслуживания к ней ведет карточка, а из статьи о признаках износа — ссылка в тексте.
Запишите адреса доноров и дату изменения в инвентаре. После этого отправьте исправленный URL через «Индексирование → Переобход страниц» в Яндекс Вебмастере. Участие страницы в поиске и динамику трафика проверьте по отчетам Яндекс Вебмастера и аналитики.
Сопоставляйте посещения роботов, статус индексации, показы, клики и нужные действия посетителей. Записывайте дату каждой правки вместе с тем, что изменили в тексте, каталоге и шаблоне. Эти записи понадобятся при оценке показателей после обновления.
💌 Еженедельная рассылка
Подпишитесь на нашу рассылку — раз в неделю будем отправлять на ваш email свежую статью из блога и другие полезные материалы.
Как не наделать новых сирот в следующий раз
Чаще всего страницы-сироты появляются не по забывчивости, а после переезда: сменили шаблон, пересобрали каталог или рубрики, и часть старых материалов осталась без раздела. По прямой ссылке такие страницы открываются, поэтому в первые недели этого никто не замечает. Мы перед любым переездом сохраняем список страниц, которые приносят посетителей, а после запуска проверяем, что до каждой из них можно дойти из меню или каталога. Это проще, чем потом искать, куда пропал трафик.
Эдуард Трубченинов, основатель агентства поискового продвижения PrivateSEO
Перед обновлением раздела найдите материалы, которые после правок останутся без переходов с доступных страниц. Заранее перенесите их в другой раздел или решите, что делать с содержимым.
Во время миграции сохраняйте старые URL вместе с назначением страниц, конечными адресами и списком страниц, с которых ведут внутренние ссылки. Когда публикуете новый материал, сразу добавляйте его в доступный раздел и связывайте с существующими публикациями по теме. После этого проверьте, можно ли дойти до него от главной.
В каталоге магазина проверьте переходы от категорий к подкатегориям и товарам, как разобрано в руководстве по перелинковке интернет-магазина. Если товар находится только через форму поиска, добавьте путь к нему из каталога. Для большой группы потерянных карточек проверьте ссылки в шаблонах.
В интернет-магазинах сиротами чаще всего становятся товарные карточки, а не статьи. Товар временно убрали из категории, он ушел на дальние страницы пагинации или находится только через поиск по сайту, хотя карточка по-прежнему открывается. Если таких карточек много, причину лучше искать в шаблоне каталога, а не исправлять ссылки по одной.
Эдуард Трубченинов, основатель агентства поискового продвижения PrivateSEO
Частота сверок зависит от того, как быстро меняется сайт. Каталог с ежедневными правками нужно проверять чаще, чем архив, который редактируют несколько раз в год. Если массово изменили категории, пагинацию или блоки рекомендаций, проведите еще один обход.
Вопросы, которые могли у вас остаться
Нужно ли включать PDF-файлы в аудит?
Если посетители должны находить на сайте опубликованные инструкции и другие PDF-документы, добавьте их адреса в инвентарь. Соберите их в группу документов и проверьте, есть ли ссылки на эти файлы в каталоге или справочном разделе.
Считается ли ссылка с изображения внутренней?
Если картинка находится внутри элемента <a> и ссылка ведет на другой документ того же сайта, такой переход считается внутренним. Адрес перехода задает атрибут <href>. Атрибут <src> у <img> указывает, откуда загрузить картинку. Поэтому в выгрузке ссылок учитывайте адрес из <href>, чтобы загрузка изображения не попала в список переходов к материалам.
/guide/ и /guide/#step-3 — это разные страницы?
Если #step-3 обозначает раздел внутри HTML-страницы, адрес с этим фрагментом и адрес без него ведут к одному документу. Часть URL после # браузер обрабатывает после загрузки и не отправляет серверу. В инвентаре считайте документ один раз, а полный адрес с фрагментом сохраните для проверки перехода к разделу.
Нужны ли ссылки на перевод, если уже настроен hreflang?
Чтобы указать поисковику языковые версии страницы, добавьте элементы <link> в раздел <head>. Переход для посетителя создайте в переключателе языка — ссылкой на перевод открытой страницы, и затем проверьте переключение в обе стороны.
Как проверить ссылки в мобильной навигации?
Откройте донора на смартфоне, раскройте меню и перейдите к нужному материалу. Если ссылка находится в карточке или блоке рекомендаций, проверьте этот элемент при узком экране. Для версии на m.example.com проверьте соответствующие страницы и переходы мобильного поддомена.