Краткое саммари
llms.txt — это файл в формате Markdown с кратким описанием сайта и ссылками на важные материалы. Его размещают по адресу https://site.ru/llms.txt. Сам файл не управляет обходом сайта, напрямую не влияет на индексацию и не гарантирует упоминание в ответах нейросетей.
Добавить такой файл можно, если сайт уже нормально открывается для роботов, важные страницы доступны, а контент обновляется. Особенно подходит llms.txt для документации, баз знаний, SaaS-продуктов, образовательных проектов, каталогов и сайтов с большим числом экспертных материалов. Если же на сайте сломаны ссылки, закрыты нужные разделы или годами не обновлялись тексты, новый файл эту проблему не решит.
По данным исследований SE Ranking и Ahrefs, наличие файла, обращения к нему и цитирование сайта нужно оценивать по разным показателям. В статье разберем, что измеряли авторы, как проверить запросы в логах и какие выводы позволяет сделать эксперимент на своем сайте.
Кстати, в августе 2026 года авторы формата выпустили вторую версию. Она уточнила размещение файлов в подпапках и способы связать обычную HTML-страницу с ее Markdown-версией. Но статуса обязательного стандарта у llms.txt по-прежнему нет.
Кому будет полезна статья:
владельцам сайтов, SEO-специалистам, маркетологам, редакторам и разработчикам, которые хотят разобраться в llms.txt.
Содержание
- Что такое llms.txt
- Чем llms.txt отличается от robots.txt и sitemap.xml
- Нужен ли llms.txt сайту в 2026 году
- Что дает файл и чего он не гарантирует
- Что измеряли авторы исследований и на каких сайтах
- Чтение файла ботом не равно росту цитирования
- Как подготовить файл
- Пример для сайта услуг
- Как создать llms.txt в WordPress и на Tilda
- Что такое llms-full.txt и когда он нужен
- Как проверить файл после публикации
- Частые ошибки при настройке
- Как наблюдать обращения к файлу в логах
- Как сравнить ответы до и после публикации
- Что можно и нельзя заключить по своему эксперименту
- Чек-лист внедрения llms.txt
- FAQ
Что такое llms.txt
Обычная веб-страница рассчитана прежде всего на человека. Кроме основного текста, в HTML есть меню, баннеры, формы, скрипты, служебные блоки и повторяющиеся элементы шаблона. Поэтому боту приходится отделять содержание от оформления и решать, какие ссылки заслуживают внимания.
llms.txt сокращает путь для ботов. В нем владелец сайта сам указывает:
что это за проект;
чем он занимается;
какие разделы содержат основную информацию;
какие страницы можно считать справочными или второстепенными;
где лежат версии материалов, удобные для машинного чтения.
Учтите, что это не полный каталог URL, для такой задачи существует sitemap.xml.
По актуальной спецификации llms.txt файл может находиться не только в корне домена, но и внутри раздела. Например, /docs/llms.txt описывает материалы в /docs/. Если для страницы подходят несколько таких файлов, агенту предлагается использовать самый близкий по пути.
При внедрении важно следить за такими нюансами наравне с доступностью описываемых страниц. Чтобы, например, несколько файлов, описывающих один и тот же контекст, не противоречили друг другу.
Буточников В.И. Head of SEO студии seobut.com
Файл читается и человеком, и программой. Его можно открыть в браузере, проверить вручную или обработать обычным Markdown-парсером.
Чем llms.txt отличается от robots.txt и sitemap.xml
Эти файлы решают разные задачи, и ни один из них не заменяет другой.
Файл | Задача | Что находится внутри | Управляет ли обходом |
robots.txt | Сообщает роботам правила доступа к разделам сайта | Директивы для разных user-agent, ссылки на карты сайта | Да, задает правила, которые робот должен учитывать |
sitemap.xml | Помогает обнаруживать страницы | Список URL и дополнительные сведения о них | Нет |
llms.txt | Дает AI-агенту краткий контекст и отобранные ссылки | Описание проекта, разделы и ссылки с пояснениями | Нет |
В llms.txt нельзя запретить обучение модели, закрыть каталог от обхода или потребовать удалить страницу из поиска. Для управления доступом используют robots.txt, настройки сервера, авторизацию и правила конкретных сервисов. Для удаления из индекса применяют предусмотренные поисковой системой способы, описание для LLM здесь не поможет.
Копировать карту сайта в llms.txt тоже не нужно. Длинный список без пояснений лишает файл смысла. Агенту полезнее будет увидеть 20 отобранных страниц с подписями, чем несколько тысяч URL товаров, тегов и архивов.
Любопытный момент: llms.txt не запрещает давать ссылки на другие ресурсы, а поэтому можно его собирать как собственный помощник обращения с внешними ссылками, например, на официальную документацию (аналог цитирования для ИИ).
Буточников В.И. Head of SEO студии seobut.com
Нужен ли llms.txt сайту в 2026 году
Обязательного требования нет. Согласно документации Chrome Lighthouse, если сервер отвечает кодом 404, проверка на наличие llms.txt помечается как неприменимая. Ошибкой считается только ситуация, когда файл заявлен или запрашивается, но сервер отвечает сбоем.
Принимать решение лучше по устройству конкретного сайта.
Стоит сделать | Можно отложить |
Есть документация, база знаний или большой справочный раздел | Сайт состоит из нескольких простых страниц |
На сайте много полезных материалов, и нужно выделить основные | Важные страницы закрыты или плохо индексируются |
Структура понятна владельцу, но сложна для нового посетителя | Контент устарел, дублируется или не отвечает на запросы |
Файл можно автоматически обновлять или регулярно проверять вручную | Некому следить за актуальностью ссылок |
Команда уже работает с AI-видимостью и анализирует упоминания бренда | От файла ждут быстрого роста трафика или позиций |
Для документации и баз знаний файл будет полезнее: так агент получит входную точку, список руководств и ссылки на чистые Markdown-версии страниц. А вот для небольшого сайта услуг эффект будет труднее отделить от качества самих страниц, известности бренда и технической доступности.
Стоимость внедрения тоже имеет значение. Если разработчику достаточно положить небольшой файл в корень сайта и добавить его обновление в обычный процесс публикации, можно пойти на эксперимент. Если же ради этого нужно перестраивать CMS, а основные страницы при этом отдают ошибки, лучше не стоит.
Что дает файл и чего он не гарантирует
Файл может подсказать боту, где находится документация, какая страница описывает тарифы, где опубликована политика возврата или какой раздел содержит проверенные ответы на частые вопросы. Так агент строит выводы больше на прямых доказательствах, а не на своих догадках.
Отсюда следуют такие плюсы:
ключевые материалы собраны в одном месте;
у ссылок есть короткие пояснения;
второстепенный контент можно отделить от основного;
агенту проще найти Markdown-версию страницы, если она существует;
структуру файла легко проверить без специальных инструментов.
Но связь между публикацией llms.txt и присутствием бренда в AI-ответах не доказана. Сам файл не подтверждает достоверность страницы, он лишь ведет к ней. Если материал неточный, устаревший или написан без источников, аккуратный список ссылок не сделает его надежным.
Не стоит ждать и прямого SEO-эффекта. llms.txt не считается фактором ранжирования, он не передает вес страницам и не ускоряет индексацию.
Есть еще одно ограничение: публикация файла не означает, что любой бот обязательно его запросит. Некоторые агенты могут использовать его, другие используют поиск, обычные ссылки или собственный индекс.
Джон Мюллер из Google в посте на Reddit сообщал, что ему неизвестно ни одной нейросети, использующей файл llms.txt, однако с того времени прошел уже год, и уже есть информация, что некоторые сервисы, по крайней мере, начали его замечать и обращаться к нему.
Что это означает? В данный момент нет общепринятого стандарта для заполнения этого файла, и он еще не прошел стадию принятия, но с большой долей вероятности индустрия примет некий единый стандарт и краулеры начнут его учитывать.
Проще говоря - хуже от его присутствия (и корректного заполнения) стать не должно, и к тому моменту когда файл станет признанным, у вас уже будет преимущество в AI-выдаче, которое ваши конкуренты могут не замечать еще месяцами.
Иван Сиваков, Senior SEO компании WSS. Специалист в области E-commerce, Fintech, Medicine, AIO
Что измеряли авторы исследований и на каких сайтах
Проверить пользу llms.txt можно на двух уровнях. Сначала выяснить, запрашивают ли его боты. А затем проверить, чаще ли сайт появляется среди источников ответов. Исследования SE Ranking и Ahrefs рассматривают разные части этого пути.
Наличие файла и частота цитирования домена
По данным исследования SE Ranking, опубликованного в ноябре 2025 года, из почти 300.000 изученных доменов файл был у 10,13%. В выборку вошли сайты с разным объемом трафика. Авторы сопоставили наличие llms.txt, посещаемость и частоту появления домена среди источников в ответах ИИ.
Для анализа использовали статистические методы и модель XGBoost, которая прогнозировала частоту цитирования по нескольким признакам. Наличие llms.txt не помогло объяснить цитирование. Когда этот признак убрали, прогноз на тестовых данных стал точнее. Хотя эти данные не подтверждают, что публикация файла сама по себе приносит больше ссылок из ответов ИИ.
Наличие файла и обращения к нему
Согласно исследованию Ahrefs за май 2026 года, команда проверила 137.210 доменов, которые использовали Ahrefs Web Analytics и получали трафик в этом месяце. Затем по данным Bot Analytics изучила запросы к llms.txt, коды ответа и user-agent — имя программы, указанное в запросе.
Файл искали в корне домена. Авторы проверяли ответ HTTP 200 и убеждались, что сервер возвращает Markdown, а не HTML-страницу с ошибкой. В этой выборке llms.txt был примерно у 28% сайтов, но 97% обнаруженных файлов за месяц не получили ни одного запроса.
То есть наличие файла даже на технически подготовленном сайте еще не означает, что к нему обращаются. Как отмечают авторы, в выборке Ahrefs больше технически подготовленных пользователей, знакомых с SEO, чем среди сайтов в целом.
Чтение файла ботом не равно росту цитирования
Запись в логе показывает запрос к адресу. Даже успешный GET с кодом 200 не раскрывает, как программа обработала полученный текст. Бот мог проверить наличие файла, собрать данные для аудита или скачать его вместе с другими URL, не используя ссылки для ответа пользователю.
По данным того же исследования Ahrefs, среди обращений к существующим файлам 96% пришлись на ботов, а 19,5% всех запросов — на программы, которые авторы отнесли к ИИ. Боты поиска для ИИ, включая OAI-SearchBot и PerplexityBot, дали лишь 1,1% всех запросов. Эти доли относятся к файлам, которые вообще получили обращения, примерно на 1,1 тыс. доменов.
Поэтому в логах нужно различать назначение посетителей. GPTBot и ClaudeBot собирают данные для обучения, OAI-SearchBot и PerplexityBot связаны с поиском, ChatGPT-User и Claude-User обращаются к страницам по запросу пользователя. Проверки SEO-сервисов и запросы Slackbot для предпросмотра ссылки тоже создают записи, но ничего не говорят о цитировании сайта.
Предположим, после отправки ссылки коллеге вы увидели обращение Slackbot к llms.txt. Это следствие предпросмотра в мессенджере. А если агент затем запросил указанную в файле страницу, вы получили повод проверить, использовал ли он ее в ответе.
Разделяйте наблюдения по мере того, как появляются данные:
- Запрос подтверждает обращение к адресу.
- Следующая загрузка страницы помогает изучить маршрут.
- Ссылка на ваш домен в сохраненном ответе подтверждает цитирование в этом ответе.
Как подготовить файл
1. Выберите страницы, которые действительно помогают понять сайт
Составьте список материалов. Для корпоративного сайта это могут быть:
главная страница с ясным описанием компании;
страницы основных услуг или продуктов;
документация и инструкции;
условия оплаты, доставки, возврата или использования;
сведения об организации и авторах;
исследования, справочные статьи и ответы на частые вопросы.
Не добавляйте служебные страницы, результаты внутреннего поиска, архивы тегов, дубли, фильтры без самостоятельной ценности и URL с параметрами отслеживания.
2. Проверьте каждую ссылку
Страница должна открываться без авторизации, отдавать корректный статус и содержать именно тот материал, который обещает подпись. Если URL ведет через цепочку редиректов или возвращает мягкую ошибку 404, сначала исправьте страницу.
Проверьте также канонический адрес. В файле не нужны одновременно версии с http и https, с www и без него, со слешем и без слеша, если сервер считает их одной страницей.
3. Соберите файл по структуре спецификации
В llms.txt обязателен только заголовок первого уровня с названием проекта. После него можно поставить краткое описание в цитате, затем при необходимости добавить пояснение и разделы второго уровня со списками ссылок.
Каждая строка со ссылкой имеет такой вид:
- [Название страницы](https://example.ru/page/): Короткое пояснение
Раздел Optional используют для второстепенных ссылок. При этом каждый агент может обработать раздел по-своему.
4. Сохраните файл в UTF-8 и опубликуйте по постоянному адресу
Для всего сайта стандартный путь — /llms.txt. Сервер должен возвращать код 200 OK. Подходит текстовый тип содержимого, который правильно отображается в браузере.
Если файл описывает отдельную документацию, его можно разместить, например, по адресу /docs/llms.txt. Спецификация v2 также предлагает указывать связь через HTML-элементы <link> или HTTP-заголовок Link: rel="describedby" ведет к подходящему llms.txt, а rel="alternate" type="text/markdown" указывает на Markdown-версию текущей страницы.
5. Назначьте ответственного за обновление
Файл быстро перестанет работать, если после редизайна половина ссылок поведет на старые адреса. Добавьте его в чек-лист релиза или настройте автоматическую генерацию из списка материалов (только если автоматизация не выгружает в файл весь сайт без разбора).
Подпишитесь на нашу рассылку — раз в неделю будем отправлять на ваш email свежую статью из блога и другие полезные материалы.
💌 Еженедельная рассылка
Пример для сайта услуг
Ниже вы найдете примерный шаблон, названия разделов можно менять под структуру вашего проекта.
# Компания «Пример»

> Разрабатываем и поддерживаем корпоративные сайты. Работаем с компаниями из России. На сайте опубликованы услуги, условия работы и практические материалы для владельцев сайтов.

Цены зависят от объема проекта. Актуальные условия указаны на страницах услуг. Для вопросов о договоре и оплате используйте страницу контактов.

## Основные страницы

- [О компании](https://example.ru/about/): реквизиты, команда и опыт работы
- [Услуги](https://example.ru/services/): список направлений и условия
- [Контакты](https://example.ru/contacts/): способы связи и время работы

## Услуги

- [Разработка сайтов](https://example.ru/services/development/): этапы, сроки и состав работ
- [Техническая поддержка](https://example.ru/services/support/): тарифы и правила обработки заявок
- [SEO-аудит](https://example.ru/services/seo-audit/): состав проверки и формат отчета

## Материалы

- [База знаний](https://example.ru/blog/): инструкции и разборы для владельцев сайтов
- [Частые вопросы](https://example.ru/faq/): ответы об оплате, сроках и поддержке

## Optional

- [Кейсы](https://example.ru/cases/): примеры выполненных проектов
- [Вакансии](https://example.ru/jobs/): открытые позиции и условия работы
Не нужно объяснять очевидное и хвалить компанию. Подпись «лучшая команда с уникальной экспертизой» ничего не сообщит агенту, а вот уточнение «реквизиты, команда и опыт работы» правильно объяснит ему содержание страницы.
Как создать llms.txt в WordPress и на Tilda
Для WordPress есть два варианта:
Создать файл вручную и разместить его в корне сайта через панель хостинга, SFTP или процесс развертывания.
Использовать SEO-плагин или отдельный генератор с поддержкой llms.txt. Например, такая функция есть у Yoast SEO и AIOSEO.
Для Tilda важно, чтобы адрес https://домен/llms.txt отдавал обычный файл без переадресации на страницу конструктора. Если текущие настройки проекта не позволяют разместить произвольный файл в корне, задачу можно решить на уровне домена, CDN или обратного прокси.
Что такое llms-full.txt и когда он нужен
llms-full.txt — большой файл, в который включают не только ссылки, но и содержимое многих страниц. Это удобно, если вам, например, нужно передать модели всю документацию одним запросом.
За объемным файлом сложнее следить, поэтому он может дублировать уже опубликованные материалы и устаревать при каждом изменении документации. Поэтому используйте llms-full.txt только если у вас есть какой-то конкретный сценарий и подключено автоматическое обновление. Создавать его на всякий случай нет необходимости.
Как проверить файл после публикации
Откройте https://ваш-домен.ru/llms.txt в приватном окне и убедитесь, что файл доступен без входа в аккаунт. Затем проверьте:
Адрес через инструмент проверки ответа сервера. Для опубликованного файла нужен код 200, а не 301, 403, 404 или 500.
Кириллица отображается правильно, без поврежденных символов.
В файле один H1 с названием проекта.
Иерархия заголовков не ломается: основные группы оформлены через H2.
Ссылки абсолютные и ведут на канонические URL.
У ссылок нет UTM-меток и временных параметров.
Ни один адрес не ведет на ошибку, авторизацию или бесконечный редирект.
Описания короткие и совпадают с содержанием страниц.
В списке нет приватных документов, тестовых заглушек и служебных адресов.
Дата последней проверки зафиксирована в рабочем регламенте, даже если ее нет в самом файле.
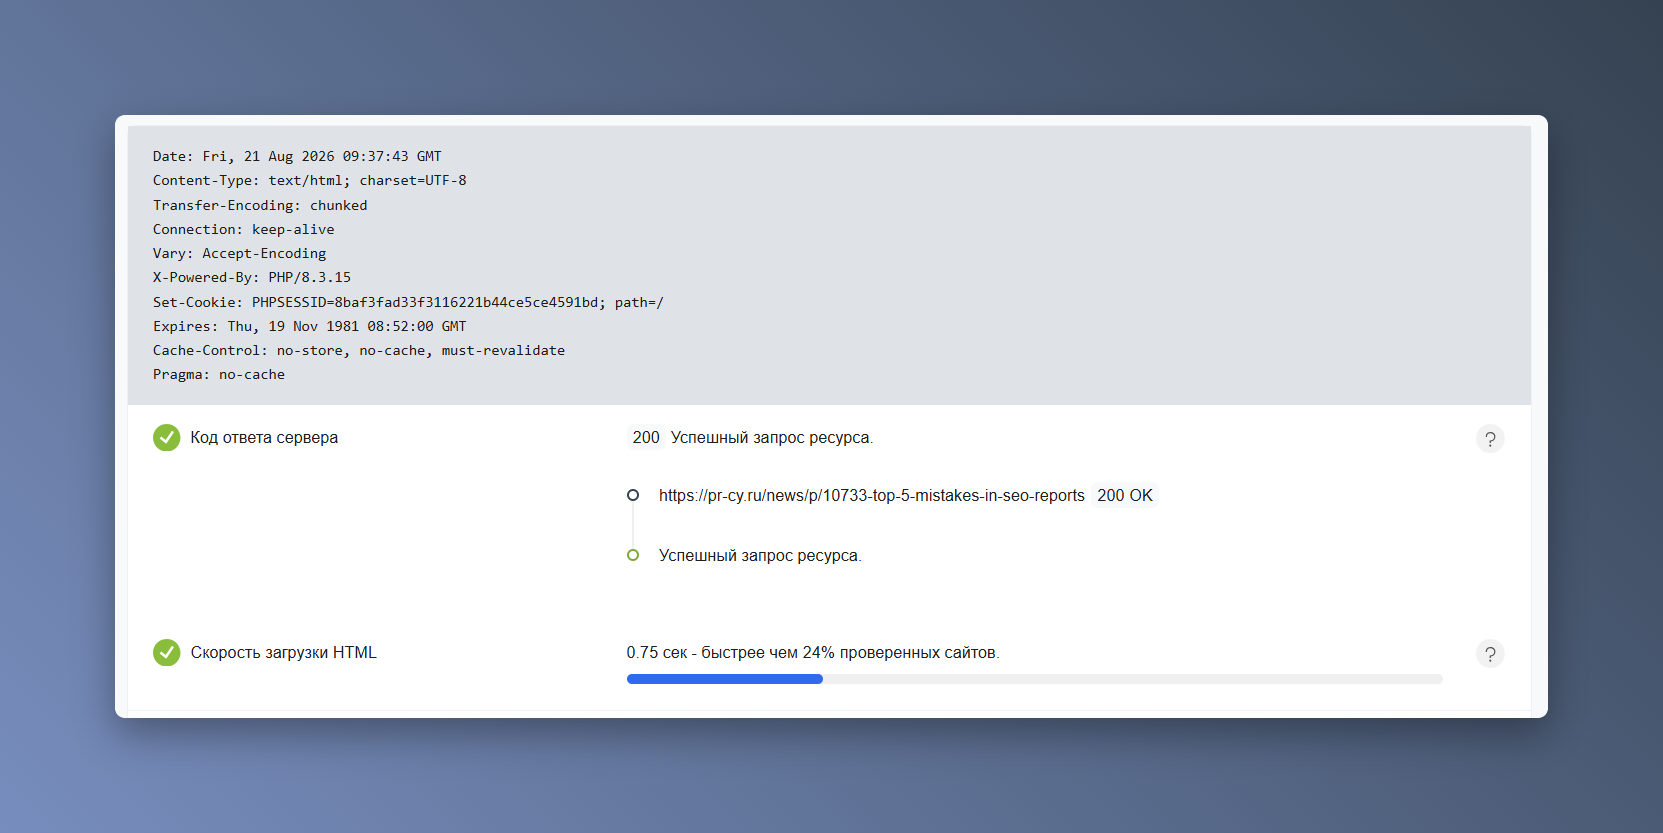
Какого-то общего валидатора, решение которого обязаны принимать все AI-системы, нет. Для синтаксиса подойдет Markdown-парсер или специализированный валидатор llms.txt, но одной технической проверки будет мало. Файл может быть формально правильным и при этом бесполезным из-за случайных ссылок.
В свежих версиях Lighthouse есть аудит llms.txt. Он помогает заметить серверную ошибку и проверить наличие файла. Качество отбора страниц и понятность описаний при этом аудит не оценивает.
Частые ошибки при настройке
Выгрузить весь sitemap
В результате получается еще одна карта сайта, только менее удобная. Оставляйте только материалы, к которым агенту есть смысл обращаться при ответе пользователю.
Написать рекламное описание
Фразы о лидерстве, инновационности и безупречном качестве только увеличивают объем текста и ничего не объясняют о продукте. Укажите назначение сайта, аудиторию, географию, ограничения и типы доступной информации.
Считать файл разрешением на обход
llms.txt ничего не открывает. Если робот заблокирован в robots.txt, на уровне CDN или авторизации, ссылка из нового файла не отменит ограничение.
Смешать актуальные и архивные страницы
Агент может выбрать старый тариф или закрытую услугу. Архив добавляют только тогда, когда он нужен для понимания темы, и прямо помечают его как архив.
Оставить битые ссылки после переезда
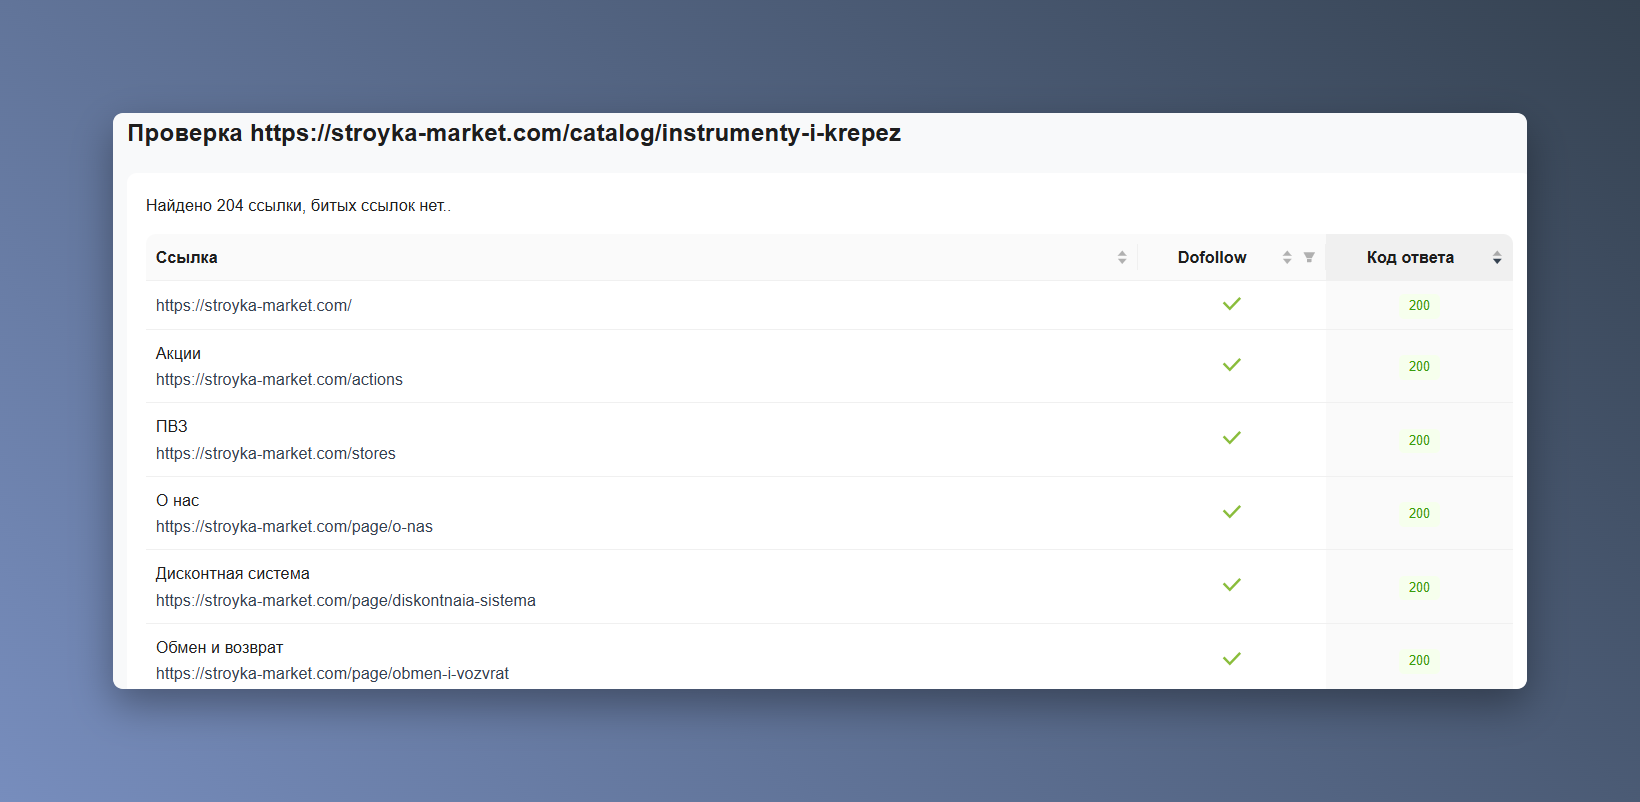
Проверяйте файл вместе с навигацией и картой сайта. Список адресов можно прогнать через проверку битых ссылок.
Публиковать внутренние данные
В файл нельзя добавлять ссылки, которые не должны быть публичными (например, черновики, документы для партнеров, панели управления и тестовые среды).
Создать и забыть
При изменении структуры сайта обновляйте llms.txt в том же релизе. Иначе он направит агента по уже устаревшему маршруту.
Как наблюдать обращения к файлу в логах
Начните с журнала HTTP-запросов на сервере или CDN. Если у вас нет доступа, попросите администратора выгрузить записи за выбранный период. В выгрузке нужны дата и время с часовым поясом, путь, метод запроса, код ответа, объём переданных данных, IP-адрес и user-agent.
Задайте фильтр по точному пути /llms.txt. Для файла в документации добавьте /docs/llms.txt или другой адрес, по которому вы его опубликовали. Поиск по подстроке llms.txt может захватить статью об этом файле. Запросы к llms-full.txt собирайте в другую группу.
Проверьте, что сервер действительно отдал файл
Разделите записи по методам и статусам. GET с кодом 200 показывает успешную загрузку ответа, но его содержимое нужно проверить — некоторые сайты вместо файла возвращают HTML-заглушку. HEAD запрашивает только заголовки. Код 404 означает, что файл по этому адресу не найден, 403 — что доступ запрещён, а 5xx — что произошла серверная ошибка. Ответ 304 означает, что клиент может использовать ранее полученную копию.
Вот пример лога:
203.0.113.10 - - [15/Oct/2026:10:00:00 +0000] "GET /llms.txt HTTP/1.1" 200 1248 "-" "ExampleBot/1.0"
203.0.113.10 - - [15/Oct/2026:10:00:02 +0000] "GET /services/seo-audit/ HTTP/1.1" 200 8450 "-" "ExampleBot/1.0"
Первая запись показывает загрузку ответа по адресу файла, вторая — обращение к странице услуги через две секунды. Числа 1248 и 8450 обозначают объем ответа в байтах в этом формате лога. Часовой пояс +0000 означает UTC, при сопоставлении с проверкой ИИ-сервиса учитывайте разницу во времени.
Определите, кто обращался и что запрашивал дальше
Сгруппируйте запросы по назначению ботов. Свою проверку, аудит SEO-сервиса и загрузку предпросмотра ссылки пометьте, чтобы не принять их за интерес ИИ-системы. User-agent можно подменить. Если оператор публикует IP-диапазоны или способ проверки бота, сопоставьте с ними адрес запроса. А неподтвержденные обращения так и обозначьте в отчете.
Затем проверьте, появлялись ли после llms.txt запросы к перечисленным в нем страницам. Совпадение IP-адреса, user-agent и времени помогает найти такие последовательности. Учтите, что у одного адреса могут быть разные процессы, а нужную страницу бот мог обнаружить через поиск или обычную навигацию.
Для каждого периода сохраняйте число обращений по категориям ботов, статусы ответа и запросы к выбранным страницам. Если сайт работает через CDN, проверьте журнал на его стороне — ответ из кеша может не попасть в лог основного сервера.
Как сравнить ответы до и после публикации
Для эксперимента выберите одну задачу. Например, проверить, чаще ли ИИ-сервис ссылается на страницу SEO-аудита, указанную в llms.txt, когда пользователь спрашивает о составе проверки и формате отчёта. Если вы меняете одновременно файл, страницу услуги и её продвижение, оценить вклад каждого изменения будет труднее.
- До публикации составьте набор вопросов по выбранной услуге. Добавьте и запросы без названия бренда, иначе проверите преимущественно ответы о компании, которую уже подсказали модели.
- Заранее выберите сервисы, режим поиска, язык и регион, где он настраивается, а также срок и частоту проверок. Повторяйте вопросы с теми же параметрами в новых диалогах, без истории предыдущего обсуждения.
- Сохраняйте вопрос, дату, полный ответ и URL источников. Считайте ответ цитированием, если в источниках есть ссылка на ваш домен. Упоминание бренда без ссылки и ссылку на конкретную страницу услуги учитывайте как разные показатели.
- Опубликуйте файл и запишите дату, адрес и версию. По возможности оставьте содержание проверяемых страниц прежним. Если за время теста менялись тексты, ссылки или настройки доступа, внесите эти изменения в журнал эксперимента.
- Повторите проверки по тому же расписанию и сопоставьте ответы с обращениями в логах. Для каждого ИИ-сервиса сравните долю ответов со ссылкой на сайт, появление нужного URL и ошибки в пересказе условий услуги.
Чтобы не собирать ответы вручную, можно использовать модуль ИИ-трекер в сервисе «Анализ сайта». Внесите вопросы по услуге, затем сопоставляйте сохранённые ответы и источники с датой публикации файла. Данные о запросах к llms.txt берите из серверных логов — они отвечают на другую часть задачи.
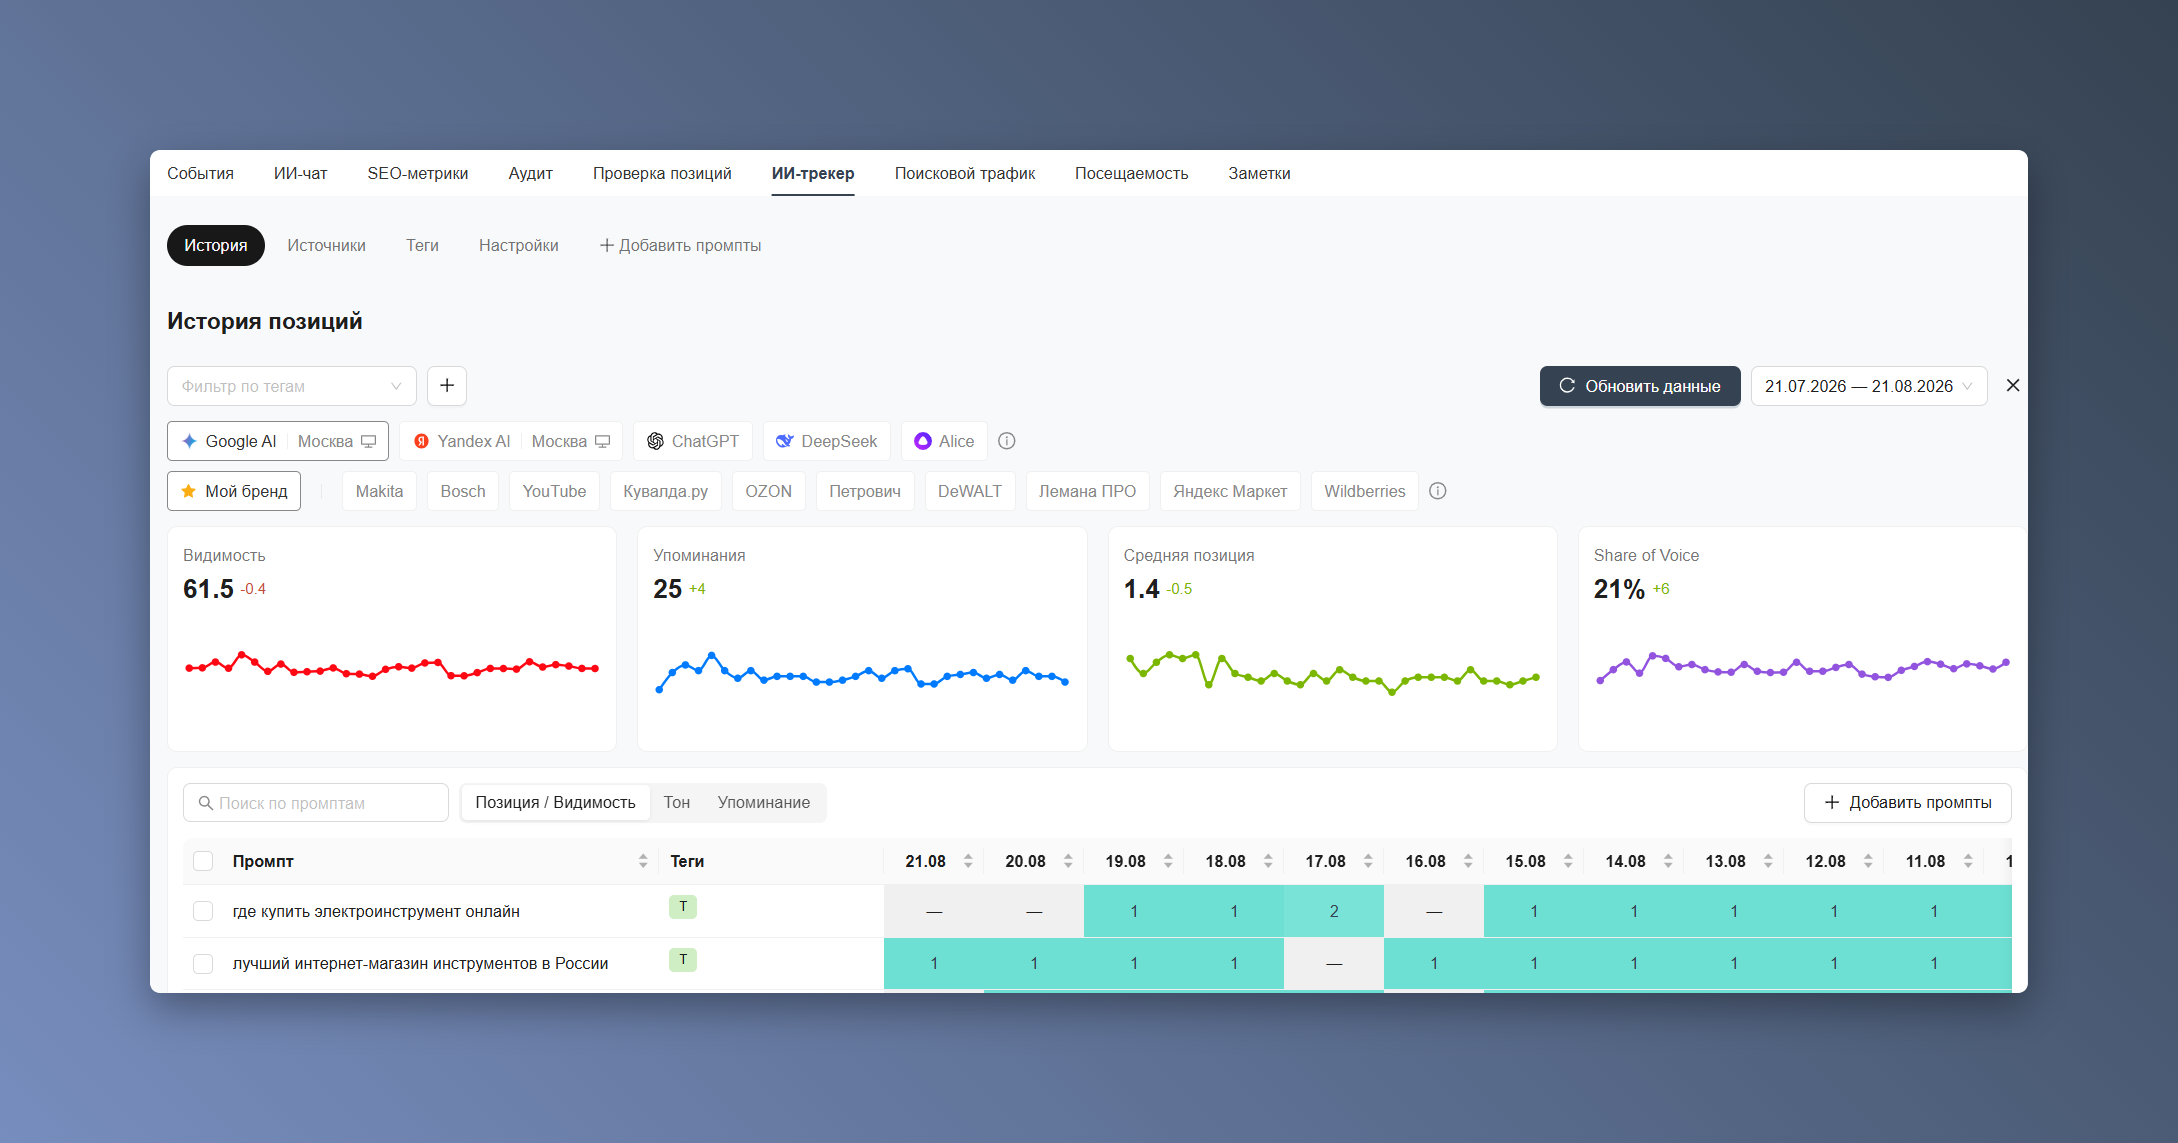
В обоих периодах считайте долю цитирования по одной формуле. Например, вы выбрали 20 вопросов и проверили каждый трижды в одном сервисе. Получилось 60 ответов до публикации и 60 после. В расчёт доли цитирования входит число ответов со ссылкой на ваш домен, делённое на общее число полученных ответов. Сбои сохраняйте в журнале и не записывайте как ответы без цитирования.
Что можно и нельзя заключить по своему эксперименту
Допустим, в тесте из 60 ответов до публикации ссылка на сайт была в 6, а после — в 12. Доля выросла с 10% до 20%, на 10 процентных пунктов. В отчете можно написать, что сайт чаще появился среди источников в выбранном наборе ответов.
Даже при прежнем содержании страниц результаты могут меняться из-за обновления модели, поискового индекса и состава источников. Если есть сопоставимые страницы или разделы, которые вы не добавляли в файл, наблюдайте и за ними. Общий рост цитирования поможет заметить изменение вне вашего теста. При этом несколько разделов одного домена не образуют полностью независимые группы — агент может использовать сведения со всего сайта.
Разбирайте результат в зависимости от того, какие наблюдения удалось получить.
- В логах нет запросов к файлу. Можно сообщить, что за выбранный период в доступных журналах обращений не обнаружено. Это не доказывает, что ни один сервис никогда его не использует. Сначала исключите пробелы в журналах и другие адреса файла.
- Файл запрашивали, но доля цитирования не изменилась. Обращения подтверждены, роста в выбранных вопросах и сервисах не обнаружено. Доступ к файлу и его влияние на ответы — разные результаты.
- После запроса к файлу появилось обращение к указанной странице и ссылка на неё в ответе. Такая последовательность согласуется с использованием маршрута из llms.txt. Для вывода о причине нужно исключить другие способы обнаружения страницы и повторить наблюдение.
- Цитирование выросло, но обращений к файлу нет. Изучайте остальные изменения и полноту логов.
В итоговой записи укажите период, вопросы и параметры сервисов, число ответов, подтверждённые обращения ботов и изменения сайта. Так вы сможете решить, продолжать ли тест, доработать ссылки в файле или направить время на содержание страниц, к которым обращаются ИИ-системы.
Чек-лист внедрения llms.txt
Определите, какую задачу должен решить файл.
Отберите главные страницы, не копируя весь sitemap.xml.
Удалите дубли, фильтры, параметры и устаревшие URL.
Напишите нейтральные пояснения к ссылкам.
Проверьте Markdown-структуру и один обязательный H1.
Проверьте, доступен ли основной контент ключевых страниц в html без выполнения JavaScript.
Сохраните файл в UTF-8.
Опубликуйте его по адресу /llms.txt или в нужной подпапке.
Проверьте код ответа, отображение текста и все ссылки.
Запланируйте обновление файла.
Следите за логами и качеством ответов AI-сервисов.
Я бы не ставил вопрос «нужен ли llms.txt для продвижения». Для Google ответ уже прямой: файл не влияет на позиции и видимость. Его потенциальная ценность в другом — это управляемый маршрут для AI-агента к каноническим материалам сайта. Но если файл ведет на устаревшие страницы, рекламные заявления без источников или конфликтующие версии фактов, мы просто сокращаем агенту путь к плохим данным.
Поэтому внедрять llms.txt стоит не как разовую SEO-настройку, а как часть контентного контура: назначить владельца, оставить только страницы с проверяемыми фактами, фиксировать версии и обновлять файл одновременно с контентом. А результат проверять не по самому факту наличия файла, а по серверным логам: кто его действительно запрашивает, какие ссылки затем открывает и получает ли агент актуальный первоисточник. Без такого процесса llms.txt остается только списком URL без измеримого эффекта.
Василий Жарков, основатель NeuroReach и ZHARKOV SEO AGENCY, эксперт по SEO и GEO. Руководитель рабочей группы ВОК по качеству данных в нейросетях и GEO.
FAQ
Читают ли нейросети файл llms.txt при каждом запросе?
Автоматического чтения при каждом запросе эти исследования не подтверждают. Как видно из документации OpenAI, Anthropic и Google, компании публикуют llms.txt у себя. Из этого нельзя заключить, что их ИИ-сервисы обязательно используют такой файл на чужом сайте.
Можно ли запретить обучение ИИ через llms.txt?
Нет, файл только описывает контент и ссылки, запретов он не устанавливает. Ограничения задают через robots.txt и настройки доступа.
Нужно ли добавлять llms.txt в robots.txt?
Спецификация этого не требует. Файл ищут по стандартному адресу или обнаруживают через связь rel="describedby".
Что добавить в файл интернет-магазину?
Добавьте категории, правила доставки и возврата, способы оплаты, гарантии, контакты и полезные инструкции по выбору товара. Не выгружайте весь каталог, если для него уже есть фиды и карта сайта. Карточки продуктов добавляйте только для ключевых или сложных продуктов с подробной документацией.
Как часто обновлять файл?
После крупных изменений структуры, адресов, услуг или документации. Если сайт меняется часто, лучше генерировать файл автоматически из заранее утвержденного набора страниц. Для корпоративного сайта достаточно проверки по редакционному графику и после крупных релизов.